ECCV 2026における本学学生の筆頭著者論文の受賞候補選出について
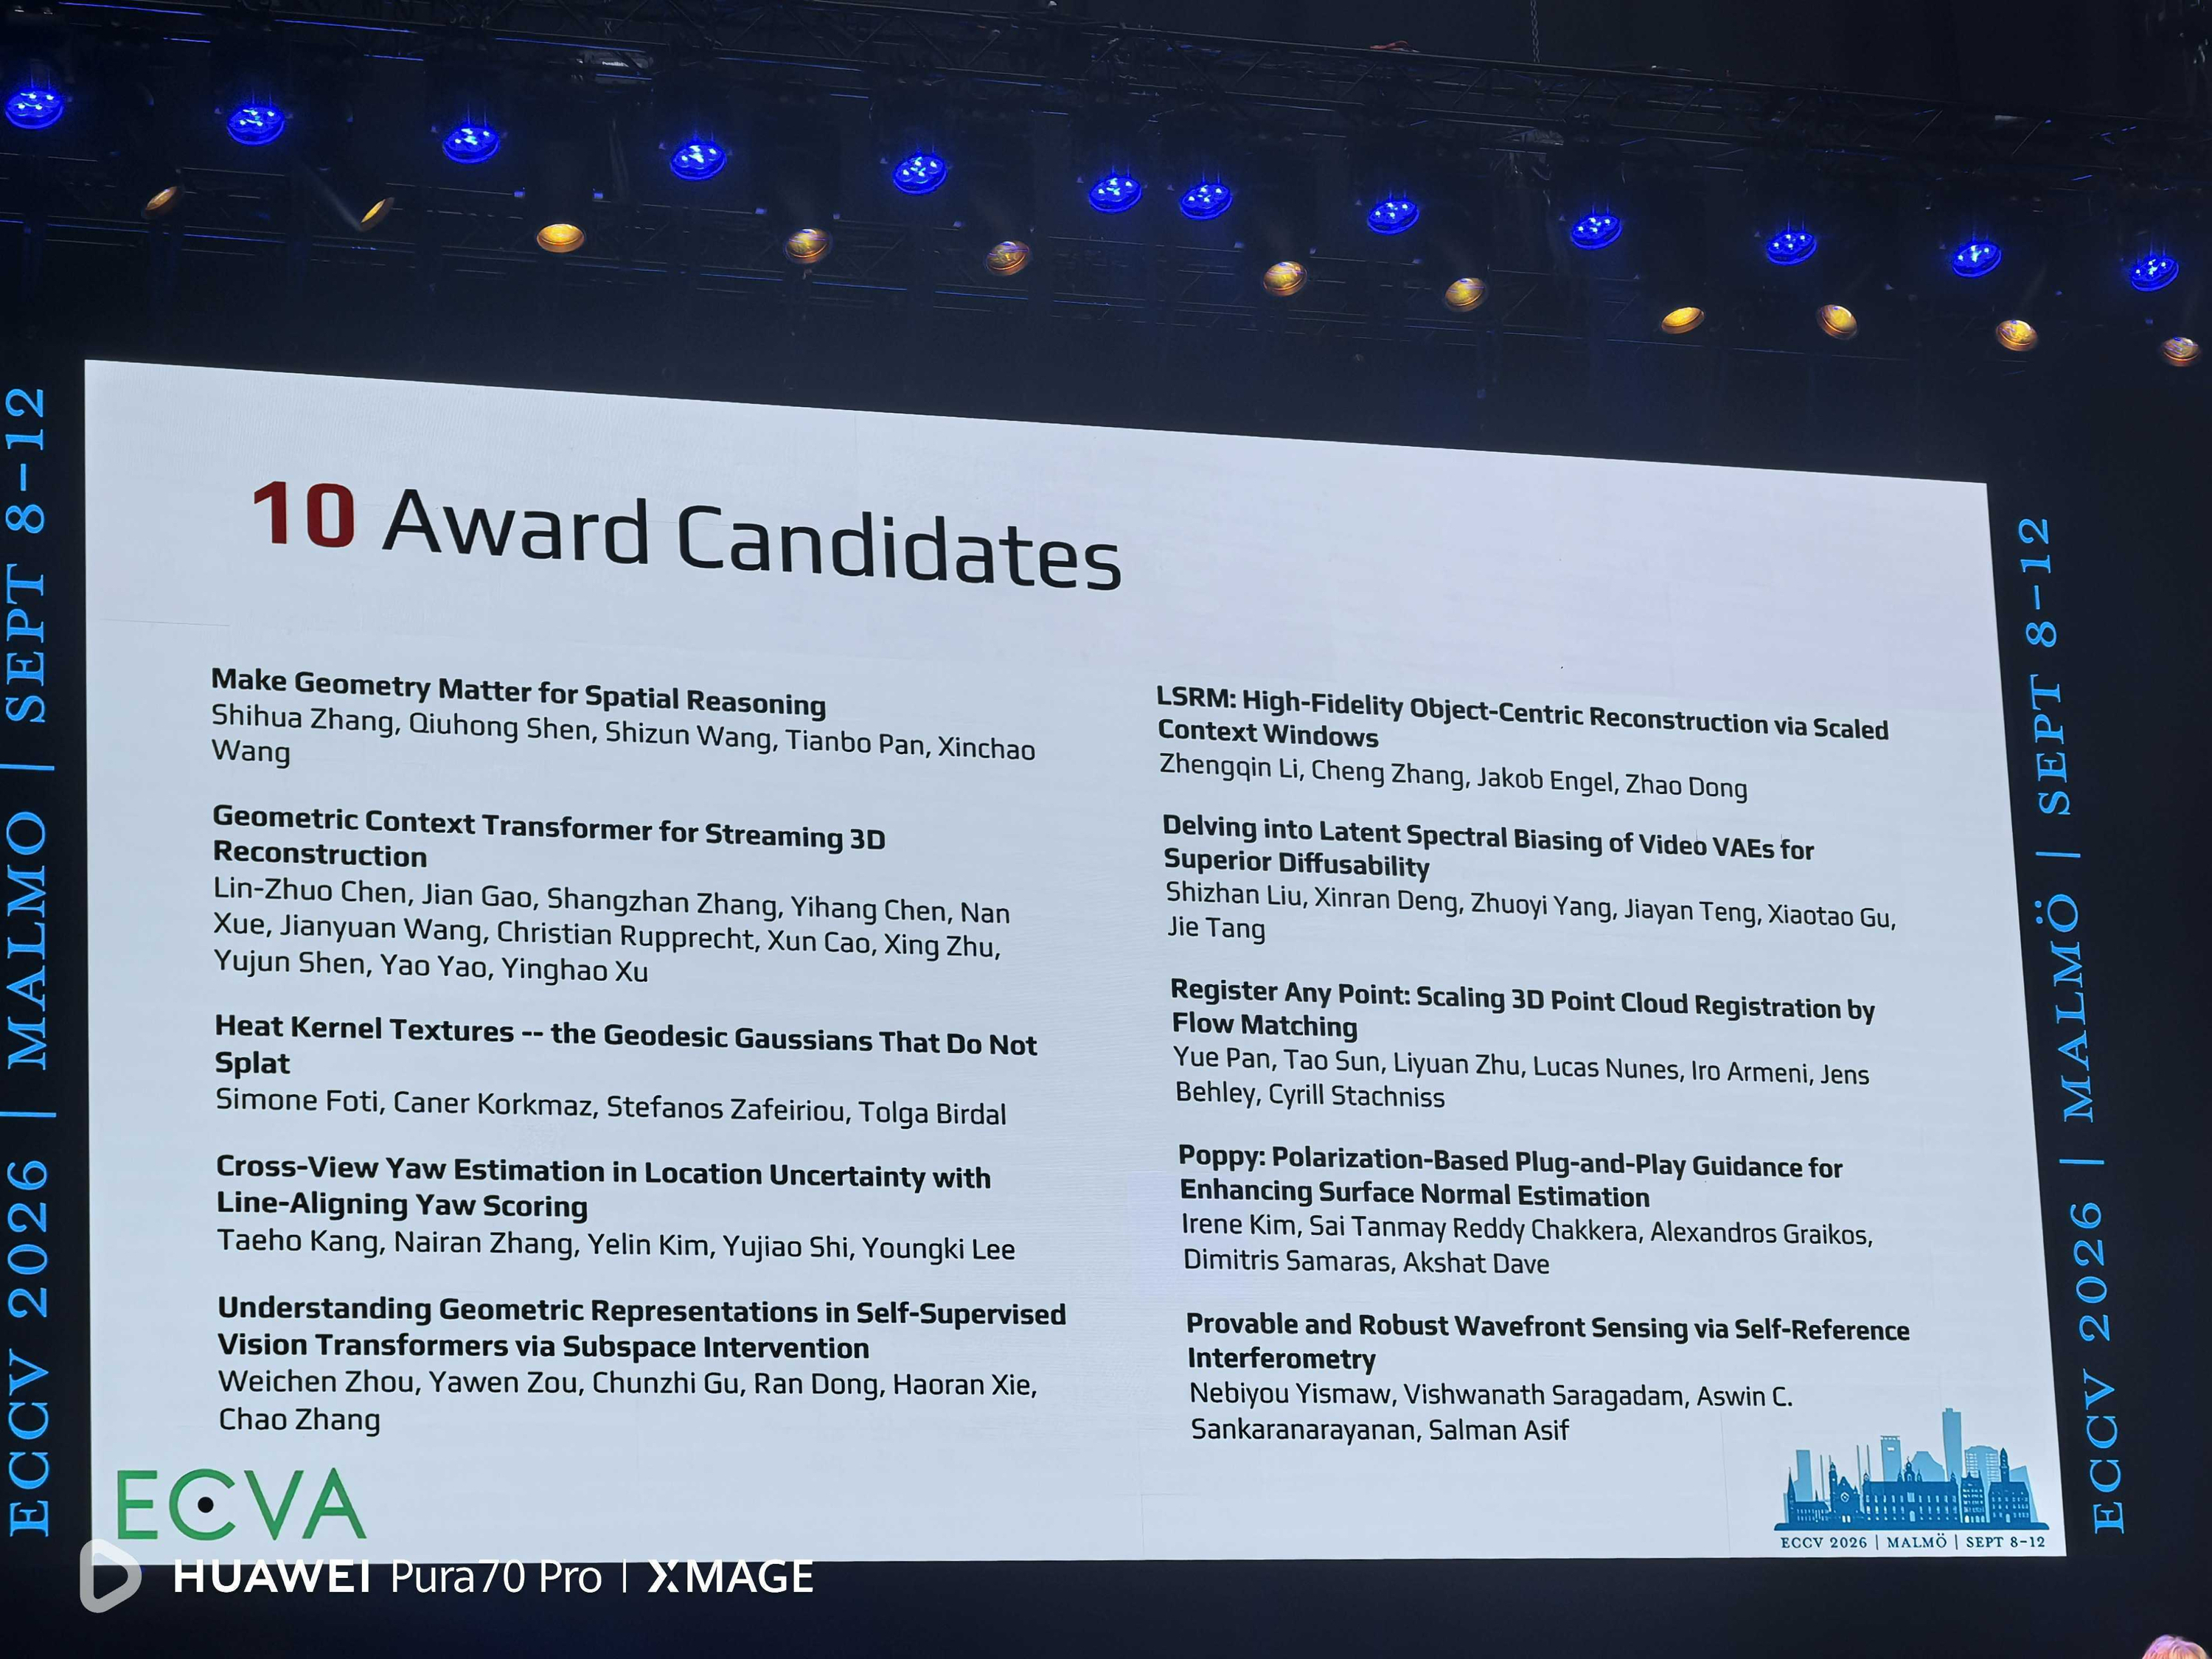
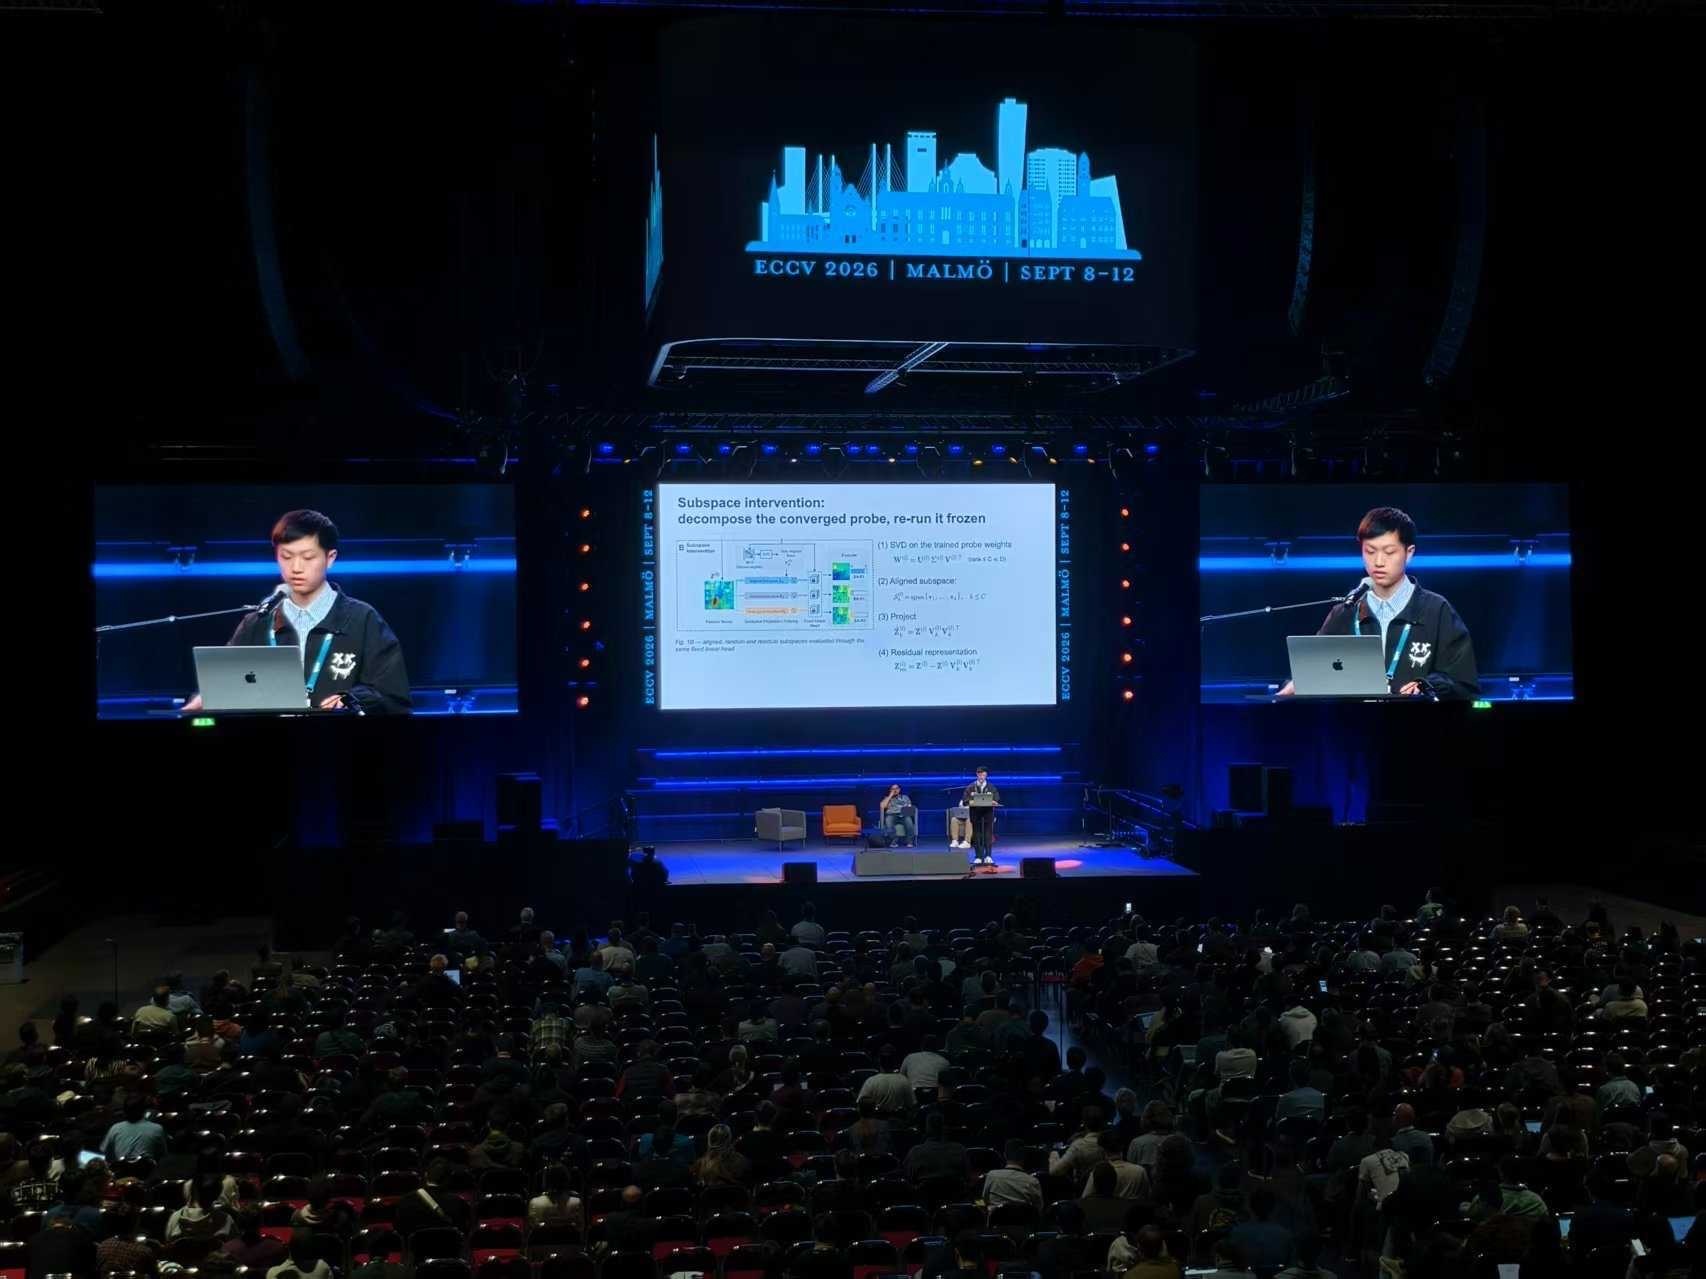
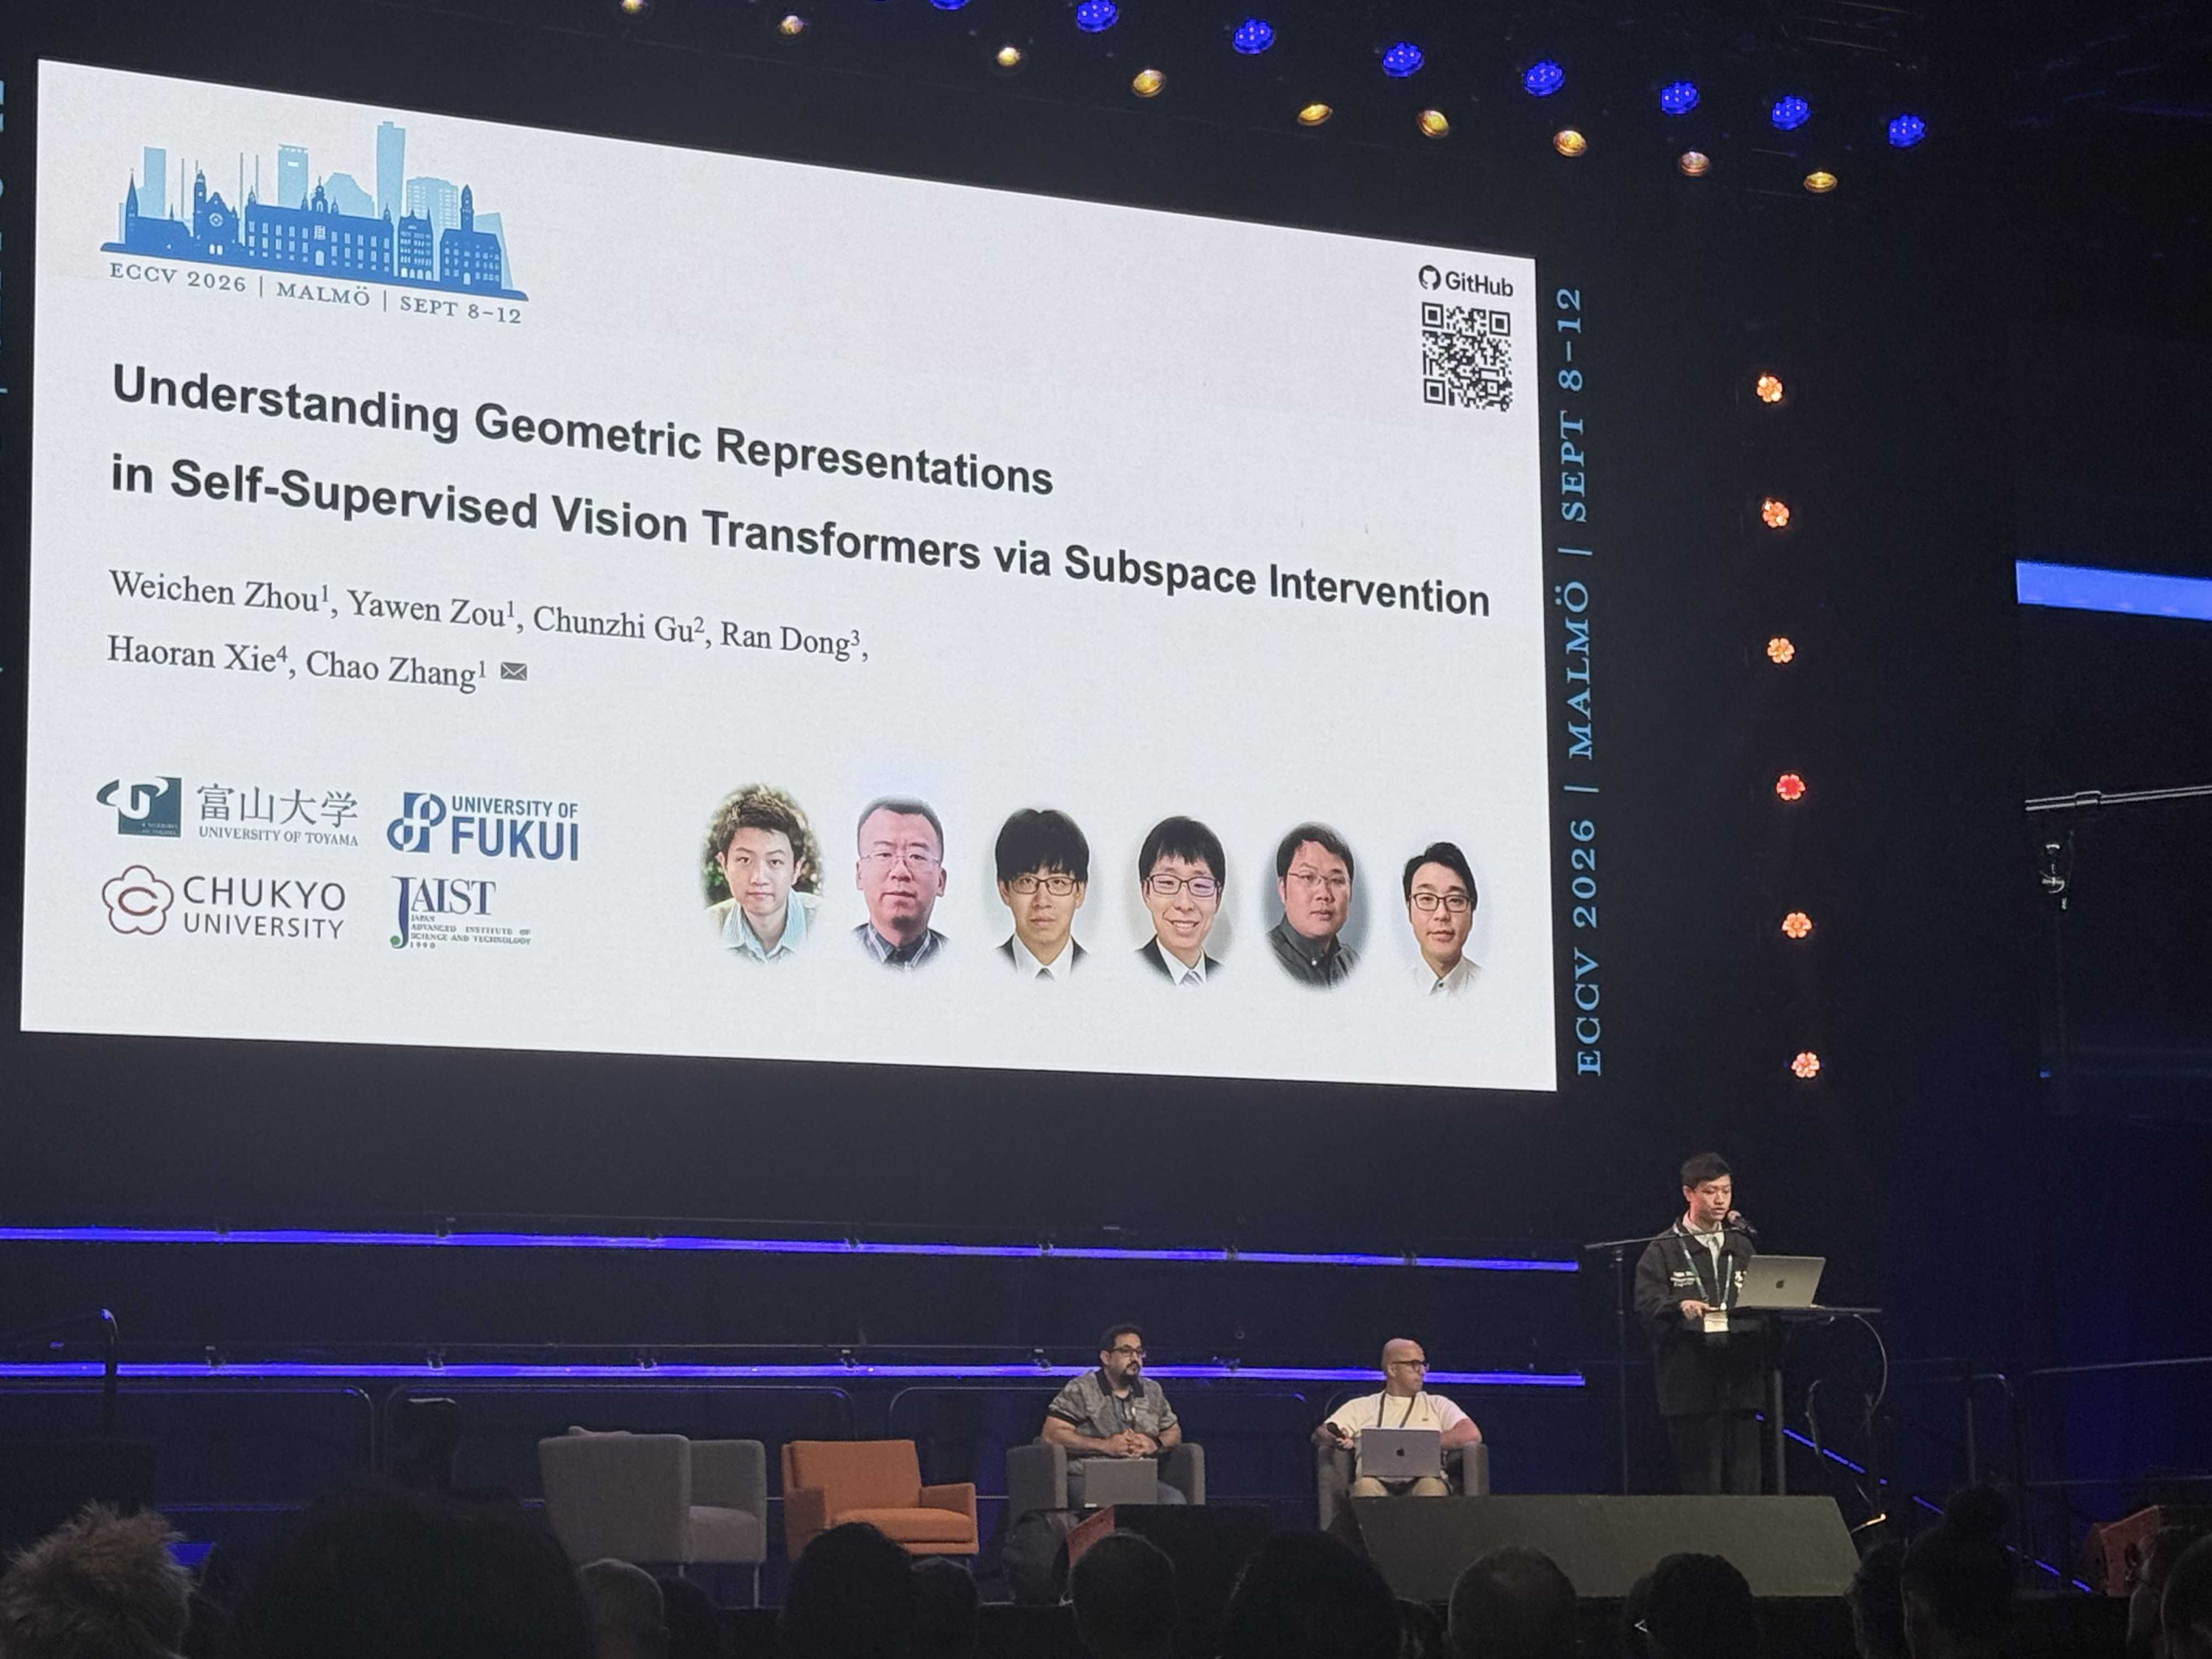
本学の学生 Weichen Zhouさんが筆頭著者を務め、張 潮 特命教授(工学部知能情報工学コース)が最終著者・責任著者として参画した論文が、国際会議ECCV 2026のlong oralに採択され、さらにAward Candidate(受賞候補)に選出されました。
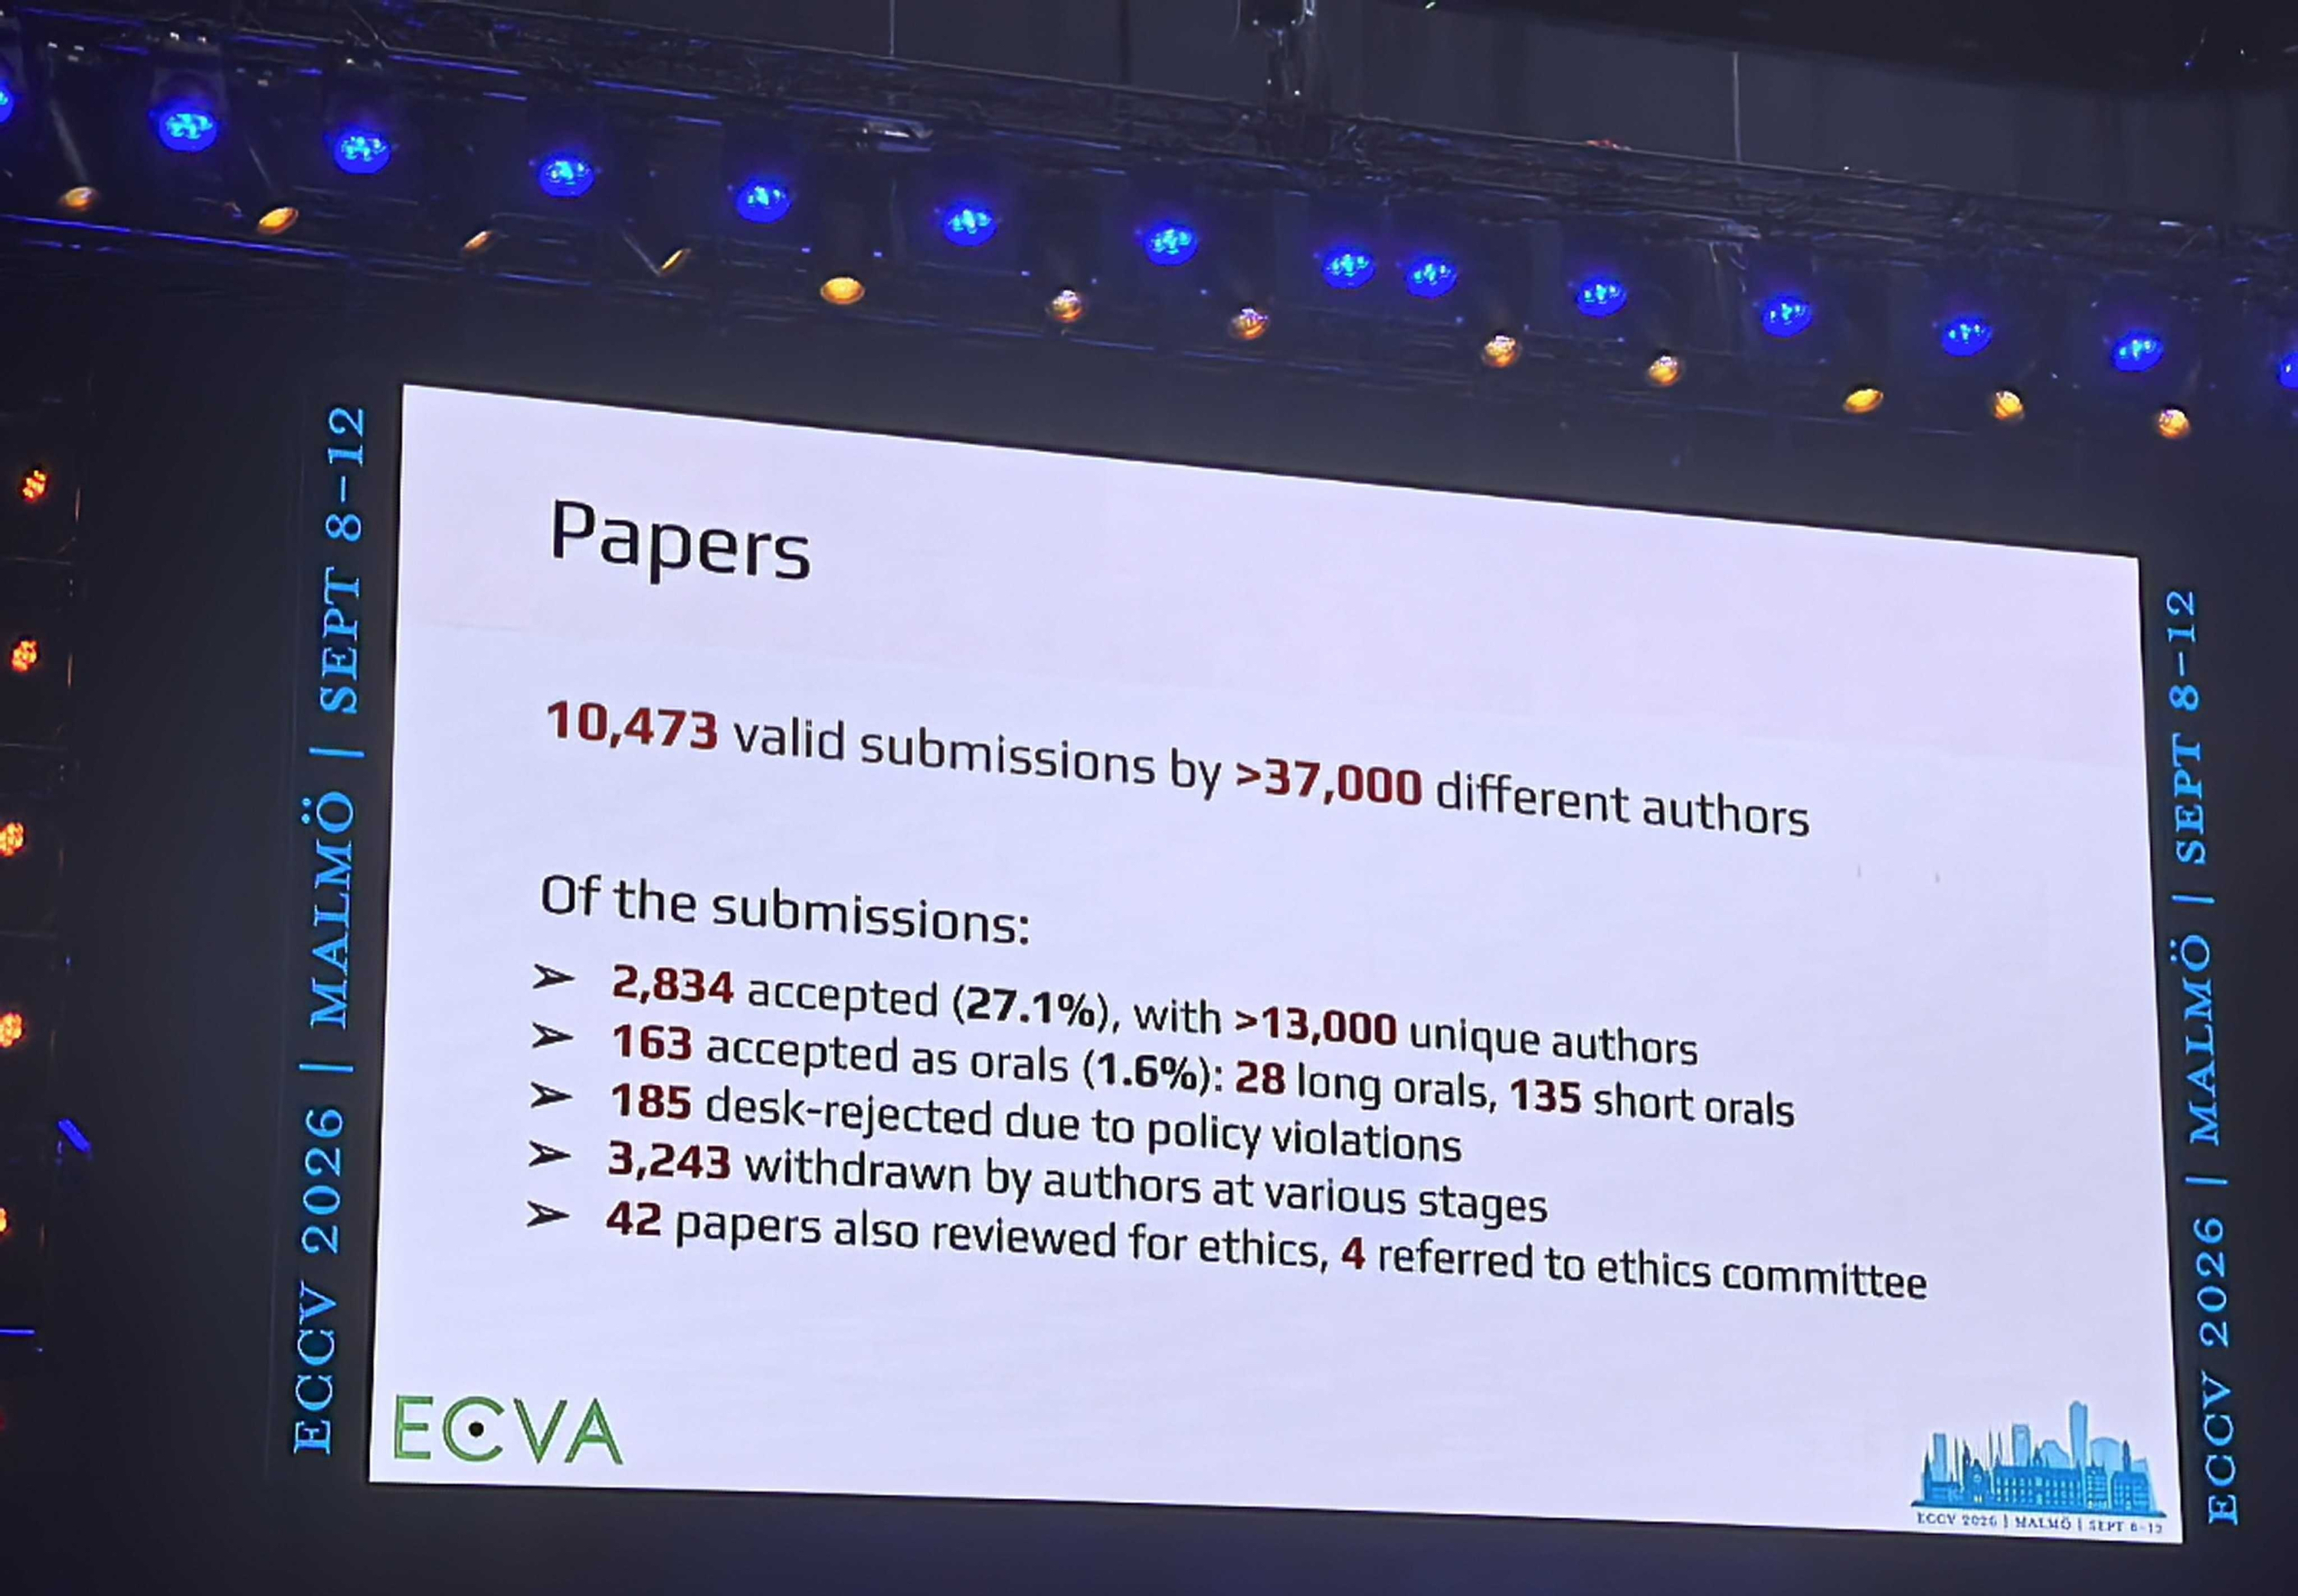
投稿総数 10,473件 のうち、受賞候補に選出されたのは 10件 です。
ECCVについて
ECCV(European Conference on Computer Vision)は、欧州コンピュータビジョン協会(ECVA)が運営する、コンピュータビジョンおよび機械学習分野の世界トップクラスの国際会議の一つです。1990年に始まり、2年に一度開催され、世界各国の大学・研究機関や企業の研究者が最先端の研究成果を発表しています。
コンピュータビジョンは、画像や映像から物体や周囲の状況を認識・理解する技術を扱う、人工知能(AI)の重要な研究分野です。ECCVは、この分野の先端研究を発信する主要な国際会議として位置づけられています。
研究について
本研究は、科学技術振興機構(JST)のCREST(課題番号:JPMJCR2554)および日本学術振興会(JSPS)の科学研究費助成事業(科研費、課題番号:JP26K02785)の支援を受けて実施されました。
研究内容と意義
本研究は、画像から学習するAIが、物体までの距離や表面の向きといった空間情報を、内部でどのように表現しているのかを調べたものです。
近年、画像に人手で正解ラベルを付けずに学習する「自己教師あり学習」が発展しています。しかし、学習したAIの内部に空間情報がどのように蓄えられ、どのように取り出せるのかは、十分に理解されていませんでした。
そこで本研究では、AI内部の特徴の一部を選択的に取り出したり除いたりし、その際の予測性能の変化を調べる「部分空間介入」という分析手法を提案しました。代表的な画像認識モデルであるDINOv2、MAE、iBOTを比較し、学習方法によって空間情報の保持のされ方や取り出しやすさが異なることを示しました。
また、単純な線形変換で取り出せる幾何情報の多くが、比較的少数の特徴方向に集約されていることを確認しました。さらに、DINOv2では、距離や表面の向きを推定するための情報は最終層より前の層で取り出しやすく、物体の種類を識別するための情報とは、適した層が異なることを示しました。
これらの知見は、視覚AIの内部構造の理解を深めるとともに、目的に応じた特徴の選択や、軽量な予測モジュールの設計に役立つことが期待されます。
論文情報
論文名
Understanding Geometric Representations in Self-Supervised Vision Transformers via Subspace Intervention
日本語参考訳
部分空間介入による自己教師ありVision Transformerの幾何表現の理解
著者
- Weichen Zhou(富山大学、筆頭著者)
- Yawen Zou(富山大学)
- Chunzhi Gu(福井大学)
- Ran Dong(中京大学)
- Haoran Xie(北陸先端科学技術大学院大学)
- Chao Zhang(富山大学、最終著者・責任著者)